- آینده NFTS و راهنمای مبتدیان NFT
- آیا طلا در سال 2023 صعود می کند؟بررسی شرایط بازار
- قیمت Dydx
- کارگزاران فارکس برای مبتدیان
- تحلیلگر بازار سهام
- درباره سفارشات ترکیبی
- آیا Etoro هنوز بهترین برای تجارت کپی است؟
- امور مالی یاهو
- افزایش نرخ بهره برای رمزنگاری چیست؟
- سفارش محدود فروش: نحوه عملکرد آن را بدانید (+ مثالها)
آخرین مطالب
امکانات وب


- اران لوی
- معماری ابری
- 1 فوریه 2022
فهرست مطالب
داده های جریان دارای قطعات متحرک زیادی هستند: کنترل رویداد ، از طریق پردازش ، ذخیره سازی و تحول. ما با O'Reilly همکاری کرده ایم تا گزارش جدیدی را برای شما در ارزیابی چگونگی مدرن سازی خطوط لوله داده خود و به حداکثر رساندن ارزش تحلیلی داده های مدرن خود به شما کمک کند. این گزارش برای مدت زمان محدود به صورت رایگان در دسترس است - نسخه خود را در اینجا بگیرید.
Kafka و RabbitMQ دو سیستم صف پیام محبوب هستند که در سیستم های پردازش جریان مورد استفاده قرار می گیرند. اما چگونه آنها متفاوت هستند ، در کجا همپوشانی دارند و چه زمانی باید یکی را بر دیگری انتخاب کنید؟برای یادگیری در ادامه بخوانید:
- آیا کافکا یا RabbitMQ برای موارد استفاده شما بهترین است؟
- معماری های مختلف رویکردهای پشت هر ابزار
- چگونه Kafka و RabbitMQ پیام رسانی را کنترل می کنند
- جوانب مثبت و منفی
- هنگامی که شما باید از راه حل های پردازش جریان پایان به پایان استفاده کنید
آیا نیاز به تبدیل داده ها در حرکت دارید؟Upsolver SQLAKE ، پلت فرم خط لوله داده All-SQL ما را در نظر بگیرید که به شما امکان می دهد یک پرس و جو بنویسید و از داده های دسته ای و جریان استفاده کنید-ضمن اتوماسیون ارکستراسیون ، بهینه سازی سیستم فایل و مدیریت زیرساخت. شما می توانید الگوهای خط لوله نمونه را اجرا کنید ، یا ساخت خود را به صورت رایگان در Upsolver SQLake شروع کنید.
اصول: Apache Kafka و RabbitMQ چیست؟
Apache Kafka و RabbitMQ دو سیستم میخانه/فرعی با پشتیبانی تجاری و پشتیبانی تجاری هستند که به راحتی توسط شرکت ها اتخاذ می شوند. RabbitMQ ابزاری قدیمی تر است که در سال 2007 منتشر شد و یک مؤلفه اصلی در سیستم های پیام رسانی و SOA بود. امروزه همچنین برای موارد استفاده از جریان استفاده می شود. Kafka ابزاری جدیدتر است که در سال 2011 منتشر شد ، که از ابتدا برای سناریوهای جریان ساخته شده است.
RabbitMQ چیست؟RabbitMQ یک کارگزار پیام با هدف کلی است که از پروتکل ها از جمله MQTT ، AMQP و Stomp پشتیبانی می کند. این می تواند با موارد استفاده از توان بالا مانند پردازش پرداخت آنلاین مقابله کند. این می تواند مشاغل پس زمینه را اداره کند یا به عنوان یک کارگزار پیام بین میکروسرویس عمل کند.
آپاچی کافکا چیست؟Kafka یک اتوبوس پیامی است که برای پخش مجدد داده های بالا و جریان ایجاد شده است. Kafka یک کارگزار پیام با دوام است که برنامه های کاربردی را قادر می سازد تا داده های پخش شده را پردازش ، پایدار و دوباره انجام دهند. کافکا یک رویکرد مسیریابی ساده دارد که از یک کلید مسیریابی برای ارسال پیام به یک موضوع استفاده می کند.
گزارش رایگان OReilly
باز کردن داده های پیچیده و جریان با خطوط لوله داده اعلانی

Kafka vs RabbitMQ - تفاوت در معماری
معماری اجزای RabbitMQ
اجزای اصلی RabbitMQ را می توان از نمودار زیر مشاهده کرد:
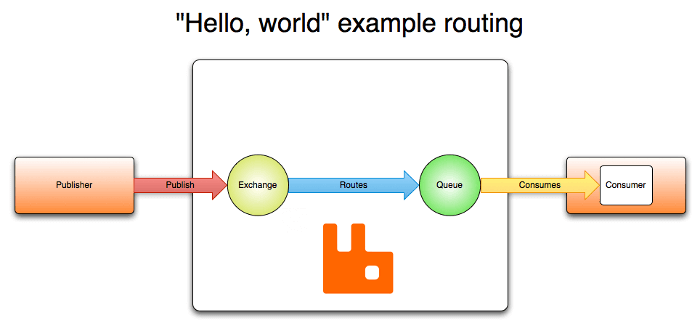
مانند سایر کارگزاران پیام ، RabbitMQ پیام هایی را از برنامه هایی که آنها را منتشر می کند - معروف به تولید کنندگان یا ناشران دریافت می کند. در داخل سیستم ، پیام ها در صرافی ها دریافت می شوند-یک "اداره پست" مجازی از انواع ، که پیام ها را به سمت جلوه های ذخیره سازی معروف به صف ها هدایت می کند. برنامه هایی که پیام ها را می خوانند ، به عنوان مصرف کننده شناخته می شوند ، می توانند در این صف ها مشترک شوند تا آخرین داده هایی را که به "صندوق های پستی" وارد می شوند ، انتخاب کنند.
ویژگی های اصلی RabbitMQ عبارتند از:
- کارگزار پیام هدف کلی-از تغییرات درخواست/پاسخ ، اشاره به نقطه و الگوهای ارتباطی میخانه استفاده می کند.
- کارگزار هوشمند / مدل مصرف کننده گنگ - تحویل مداوم پیام ها به مصرف کنندگان ، با همان سرعت کارگزار نظارت بر وضعیت مصرف کننده.
- پلت فرم بالغ --ول پشتیبانی شده ، برای جاوا ، کتابخانه های مشتری ، . NET ، Ruby ، Node. js. در دسترس است. ده ها افزونه ارائه می دهد.
- ارتباط - می تواند همزمان یا ناهمزمان باشد.
- سناریوهای استقرار - سناریوهای اعزام توزیع شده را ارائه می دهند.
- خوشه چند گره به فدراسیون خوشه ای-که به خدمات خارجی تکیه نمی کنند ، با این حال ، افزونه های خاص تشکیل خوشه می توانند از DNS ، API ، کنسول و غیره استفاده کنند.
معماری آپاچی کافکا
می توانید اجزای اصلی یک خوشه کافکا را در زیر مشاهده کنید:
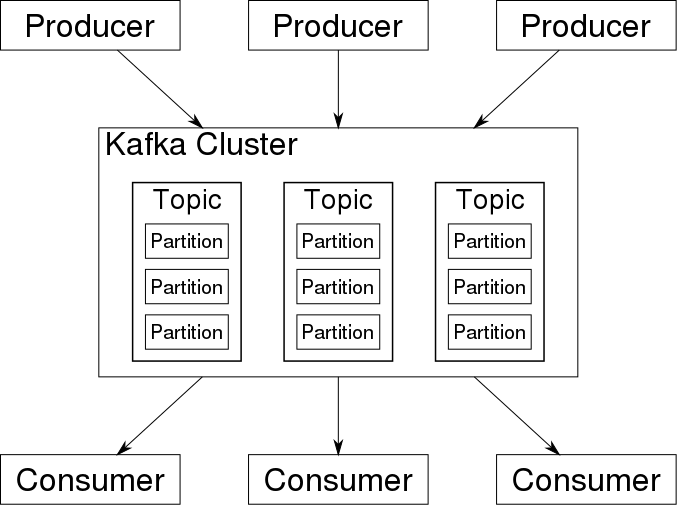
تولید کنندگان و مصرف کنندگان در اینجا یکسان هستند - برنامه هایی که پیام های رویداد را منتشر و می خوانند. همانطور که ما در مورد موارد استفاده از کافکا بحث کردیم ، یک رویداد پیامی با داده هایی است که این رویداد را توصیف می کند ، مانند یک کاربر جدید که در یک برنامه تلفن همراه ثبت نام کرده است. رویدادها در موضوعات کافکا صف می شوند و مصرف کنندگان متعدد می توانند در همان موضوع مشترک شوند. موضوع بیشتر به پارتیشن ها تقسیم می شود ، که داده ها را در بین کارگزاران تقسیم می کنند تا عملکرد را بهبود بخشند.
ویژگی های مهم کافکا عبارتند از:
- پیام های انتشار و پیامدهای مربوط به حجم بالا-قابل قبول ، سریع و مقیاس پذیر.
- فروشگاه پیام بادوام - Kafka مانند یک ورود به سیستم رفتار می کند ، در یک خوشه سرور اجرا می شود ، که جریان سوابق را در موضوعات (دسته ها) نگه می دارد.
- پیام ها از یک مقدار ، یک کلید و یک جدول زمانی تشکیل شده اند.
- DUMP BROKER / SMART CONDER MODEL - سعی نمی کنید پیگیری کنید که پیام ها توسط مصرف کنندگان خوانده می شود و فقط پیام های خوانده نشده را حفظ می کند. کافکا تمام پیام ها را برای یک دوره زمانی مشخص نگه می دارد.
- مدیریت شده توسط خدمات خارجی - در بسیاری از موارد این Apache Zookeeper خواهد بود.
رویکرد فشار در مقابل فشار - Kafka و RabbitMQ مقایسه شده است
یکی از تفاوت های مهم بین کافکا و RabbitMQ در این است که اولی مبتنی بر کشش است ، در حالی که دیگری مبتنی بر فشار است. در سیستم های مبتنی بر کشش ، کارگزاران منتظر هستند تا مصرف کننده داده ها را درخواست کند ("کشش"). اگر یک مصرف کننده دیر شود ، بعداً می تواند به دست آورد. با سیستم های مبتنی بر فشار ، پیام ها بلافاصله به هر مصرف کننده مشترک منتقل می شوند. این می تواند باعث شود این دو ابزار در برخی شرایط متفاوت رفتار کنند.
Apache Kafka: رویکرد مبتنی بر کشش
کافکا از یک مدل کشش استفاده می کند. مصرف کنندگان از یک افست خاص دسته ای از پیام ها را درخواست می کنند. Kafka اجازه می دهد تا طولانی مدت ، که مانع از حلقه های تنگ در صورت عدم پیغام گذشته از جبران می شود ، و پیام های تهاجمی را برای پشتیبانی از این امر دسته بندی می کند
یک مدل کشش برای کافکا به دلیل ساختار داده های تقسیم شده منطقی است. کافکا سفارش پیام را در یک پارتیشن بدون مصرف کننده های مدعی ارائه می دهد. این امر به کاربران امکان می دهد تا از پیام های ارسال پیام مؤثر و توان بالاتر استفاده کنند.
RabbitMQ: رویکرد مبتنی بر فشار
RabbitMQ از یک مدل فشار استفاده می کند و از طریق محدودیت پیش تنظیم تعریف شده بر روی مصرف کننده ، مصرف کنندگان را بیش از حد متوقف می کند. این می تواند برای پیام رسانی کم تأخیر استفاده شود ..
هدف از مدل فشار توزیع پیام ها به صورت جداگانه و سریع ، برای اطمینان از اینکه کار به طور مساوی موازی شده است و پیام ها تقریباً به ترتیب که در صف وارد شوند ، پردازش می شوند. با این حال ، این همچنین می تواند در مواردی که یک یا چند مصرف کننده "جان خود را از دست داده اند" ایجاد کند و دیگر پیام دریافت نمی کند.
RabbitMQ در مقابل Kafka - چگونه آنها پیام رسانی را کنترل می کنند؟
| ابزار | آپاچی کافکا | خرگوش |
| سفارش پیام | به لطف پارتیشن بندی آن ، سفارش پیام را ارائه می دهد. پیام ها توسط کلید پیام به موضوعات ارسال می شوند. | پشتیبانی نشده. |
| طول عمر پیام | Kafka یک ورود به سیستم است ، به این معنی که پیام ها را به طور پیش فرض حفظ می کند. شما می توانید این کار را با مشخص کردن یک خط مشی حفظ مدیریت کنید. | RabbitMQ یک صف است ، بنابراین پیام ها با مصرف یک بار از بین می روند و تصدیق ارائه می شود. |
| ضمانت های تحویل | سفارش را فقط در یک پارتیشن حفظ می کند. در یک پارتیشن ، کافکا تضمین می کند که کل دسته پیام ها یا از بین می روند یا عبور می کنند. | حتی در رابطه با معاملات مربوط به یک صف واحد ، اتمی را تضمین نمی کند. |
| اولویت های پیام | N/A | در RabbitMQ می توانید اولویت های پیام را مشخص کنید و ابتدا پیام با اولویت بالا مصرف کنید. |
کتابخانه ها و زبانهای برنامه نویسی پشتیبانی شده
براساس راهنمای مقدمه ارائه شده در وب سایت Apache Kafka ، Kafka انواع زبانهای برنامه نویسی و کتابخانه ها را به مشتریان ارائه می دهد. این شرکت با برخی از مشتری ها شامل می شود ، که توسط ده ها مشتری ارائه شده توسط جامعه کافکا تقویت شده است. این مشتری ها برای جاوا و اسکالا از جمله کتابخانه سطح بالاتر کافکا ، برای GO ، پایتون ، C/C ++ و بسیاری از زبان های برنامه نویسی دیگر و همچنین API های REST در دسترس هستند. علاوه بر این ، Kafka Coect صدها اتصالات آماده برای استفاده برای سیستم ها و برنامه های خارجی را فراهم می کند.
مطابق با قابلیت همکاری مقاله در جریان های RabbitMQ و لیست پروتکل های پشتیبانی شده ، RabbitMQ از طیف گسترده ای از کتابخانه ها و زبانهای برنامه نویسی مانند جاوا ، GO ، . NET و بسیاری دیگر پشتیبانی می کند. و همچنین پروتکل های AMQP 0. 9. 1 ، AMQP 1. 0 ، Stomp و MQTT. همچنین تعداد زیادی از کتابخانه های مشتری برای زبان ها و محیط های مختلف برنامه نویسی در دسترس هستند ،
کافکا در مقابل عملکرد RabbitMQ
Apache Kafka:
کافکا عملکرد بسیار بالاتری نسبت به کارگزاران پیام مانند RabbitMQ ارائه می دهد. از دیسک متوالی I/O برای تقویت عملکرد استفاده می کند و آن را به گزینه ای مناسب برای اجرای صف ها تبدیل می کند. این می تواند با منابع محدود به توان بالا (میلیون ها پیام در ثانیه) برسد ، یک ضرورت برای موارد بزرگ استفاده از داده ها.
RabbitMQ:
RabbitMQ همچنین می تواند یک میلیون پیام در ثانیه پردازش کند اما به منابع بیشتری نیاز دارد (حدود 30 گره). شما می توانید از RabbitMQ برای بسیاری از موارد مشابه Kafka استفاده کنید ، اما باید آن را با ابزارهای دیگری مانند Apache Cassandra ترکیب کنید.
بهترین موارد استفاده چیست؟
Apache Kafka از موارد استفاده می کند
Apache Kafka خود کارگزار را فراهم می کند و به سمت سناریوهای پردازش جریان طراحی شده است. اخیراً ، کافکا جریان ، کتابخانه مشتری برای ساخت و ساز برنامه ها و خدمات میکروسرویس را اضافه کرده است. Apache Kafka از مواردی از قبیل معیارها ، ردیابی فعالیت ، جمع آوری ورود به سیستم ، پردازش جریان ، سیاهههای مربوطه و منابع رویداد پشتیبانی می کند.
سناریوهای پیام رسانی زیر مخصوصاً برای کافکا مناسب است:
- جریانی با مسیریابی پیچیده ، توان رویدادهای 100k/ثانیه یا بیشتر ، با سفارش "حداقل یک بار".
- برنامه های کاربردی که به تاریخچه جریان نیاز دارند ، که در سفارش "حداقل یک بار" تحویل داده شده است. مشتریان می توانند "پخش" جریان رویداد را مشاهده کنند.
- منابع منابع ، مدل سازی در یک سیستم به عنوان دنباله ای از وقایع تغییر می کند.
- داده های پردازش جریان در خطوط لوله چند مرحله ای. خطوط لوله نمودارهایی از جریان داده های زمان واقعی را تولید می کنند.
RabbitMQ از موارد استفاده می کند
از RabbitMQ می توان استفاده کرد که سرورهای وب نیاز به پاسخ سریع به درخواست ها دارند. این امر نیاز به انجام فعالیتهای فشرده منابع را از بین می برد در حالی که کاربر منتظر نتیجه است. RabbitMQ همچنین برای انتقال پیام به گیرندگان مختلف برای مصرف یا به اشتراک گذاری بارهای بین کارگران تحت بار زیاد (20K+ پیام/ثانیه) استفاده می شود.
سناریوهایی که RabbitMQ برای:
- برنامه هایی که نیاز به پشتیبانی از پروتکل های میراث مانند Stomp ، MQTT ، AMQP ، 0-9-1 دارند.
- کنترل گرانول بر قوام/مجموعه ضمانت ها بر اساس هر پیام
- مسیریابی پیچیده به مصرف کنندگان
- برنامه هایی که نیاز به انواع انتشار/مشترک شدن دارند ، قابلیت های پیام به پاسخ/پاسخ را دارند.
Kafka و RabbitMQ: جمع بندی
این راهنما تفاوت های عمده و شباهت های بین Apache Kafka و RabbitMQ را در بر گرفته است. هر دو می توانند چندین میلیون پیام در ثانیه مصرف کنند ، اگرچه معماری آنها متفاوت است و هر یک در محیط های خاص عملکرد بهتری دارند. RabbitMQ با استفاده از یک خوشه بزرگ (30+ گره) پیام های خود را تقریباً درون حافظه کنترل می کند. به طور مقایسه ای ، کافکا عملیات I/O دیسک متوالی را اعمال می کند و بنابراین سخت افزار کمتری را می طلبد.
برای کسب اطلاعات بیشتر در مورد تفاوت های بین کافکا و سایر کارگزاران پیام ، راهنمای ما به Kafka vs Kinesis را بررسی کنید ، مورد واژه نامه ما که جریان داده های Kinesis را تعریف می کند.
شما داده های جریان را در کافکا دارید. بعد چیست؟
دریافت داده های خود در Kafka فقط اولین قدم است - برای اینکه در واقع ارزش آن را هدایت کنید ، به راهی برای ذخیره سازی ، مدیریت و تجزیه و تحلیل جریان های خود نیاز دارید. برای یادگیری چگونگی دستیابی به آن ، پست محبوب ما را در مورد Apache Kafka با یا بدون دریاچه داده بررسی کنید.
همچنین می توانید SQLake را به مدت 30 روز به صورت رایگان امتحان کنید. SQLake جدیدترین پیشنهاد Upsolver است. این امکان را به شما می دهد تا از طریق یک تجربه All SQL ، خطوط لوله داده قابل اعتماد را در مورد داده های جریان و دسته ای بسازید و اجرا کنید. آن را به صورت رایگان امتحان کنید - کارت اعتباری لازم نیست.
منتشر شده در: وبلاگ ، معماری ابر
اران لوی
Eran به عنوان یک متخصص سئو و نویسنده محتوا در Upsolver ، دانش زیادی را از فعالیت ده ساله خود در صنعت داده به ارمغان می آورد. وی در طول سفر حرفه ای خود ، موقعیت های محوری را در Sisense ، Adaptavist و Webz. io برگزار کرده است. کارهای مکتوب Eran در سیستم عامل های مورد احترام ، از جمله DZONE ، Smart Data Collective و وبلاگ بزرگ داده های وب آمازون به نمایش گذاشته شده است. با eran در LinkedIn ارتباط برقرار کنید
سیگنالهای معاملاتی...
ما را در سایت سیگنالهای معاملاتی دنبال می کنید
برچسب :
نویسنده : عارف لرستانی
بازدید : <-PostHit->
خبرنامه
